背景・課題
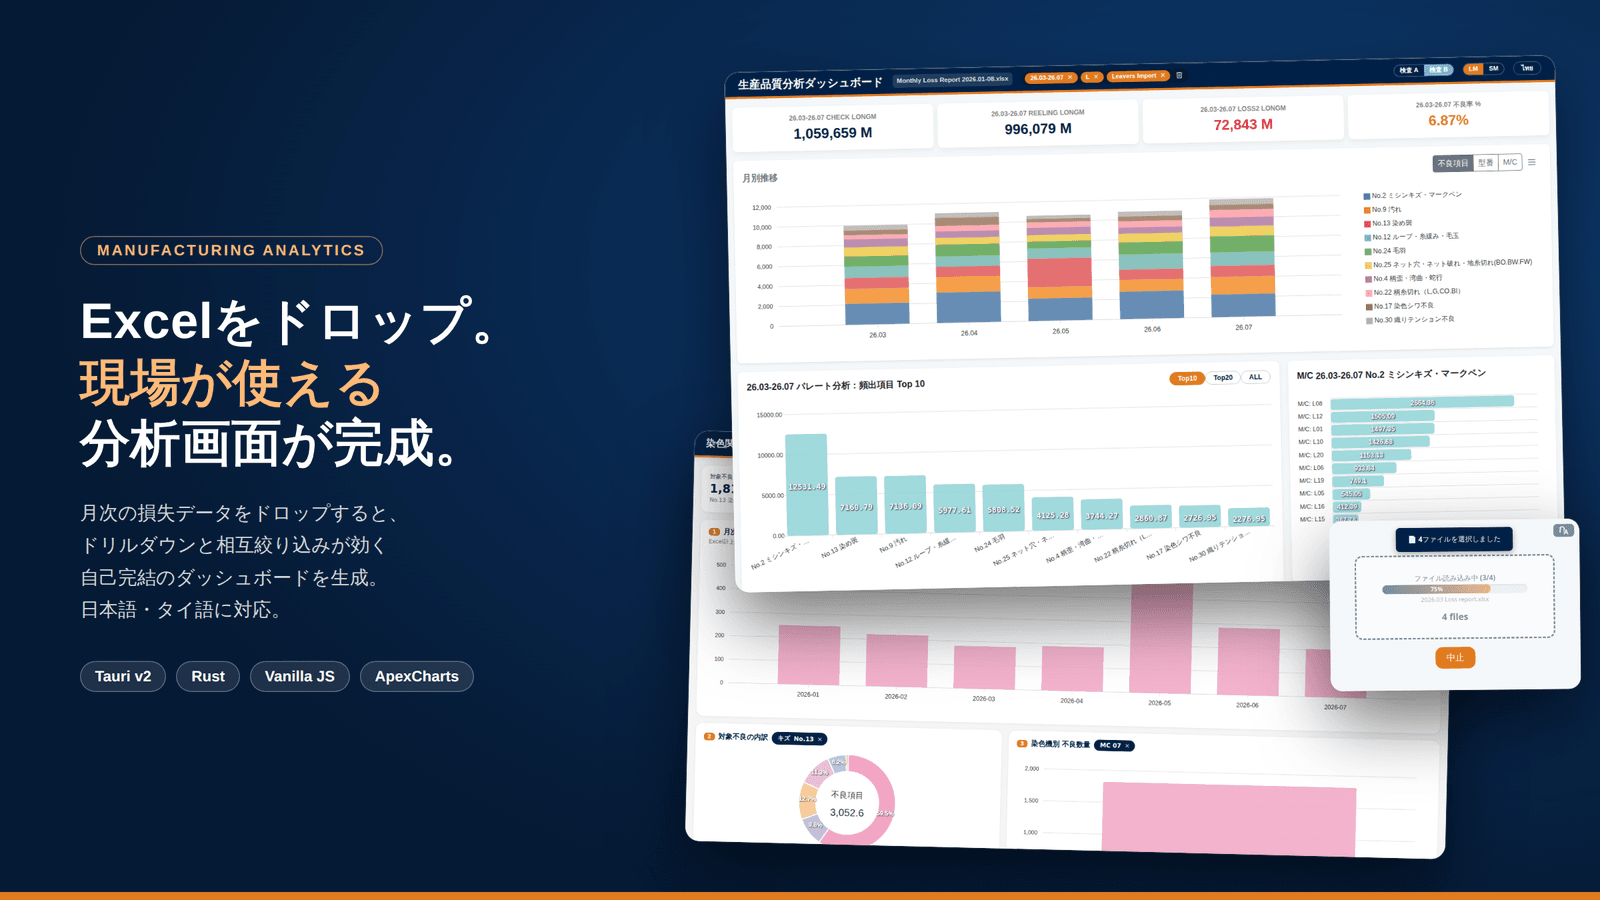
製造工程では、月ごとの損失データが工程・機種・型番・製造番号という粒度で1つのExcelブックに蓄積されます。1ファイルあたり数MBのシートが複数あり、「どの不良が、どの型番で、どの機械で多いのか」を知るには、フィルタと目視で集計し直す必要がありました。 さらに、この結果を読む人は現場の担当者から管理職までさまざまで、拠点にはタイ語話者も含まれます。「分析できる人」だけが数字を持っている状態では、改善の議論が始まりません。そこで、専用の環境がない人でも開けて、その場で絞り込んで原因に迫れる形にすることを目標にしました。
主要機能・特徴
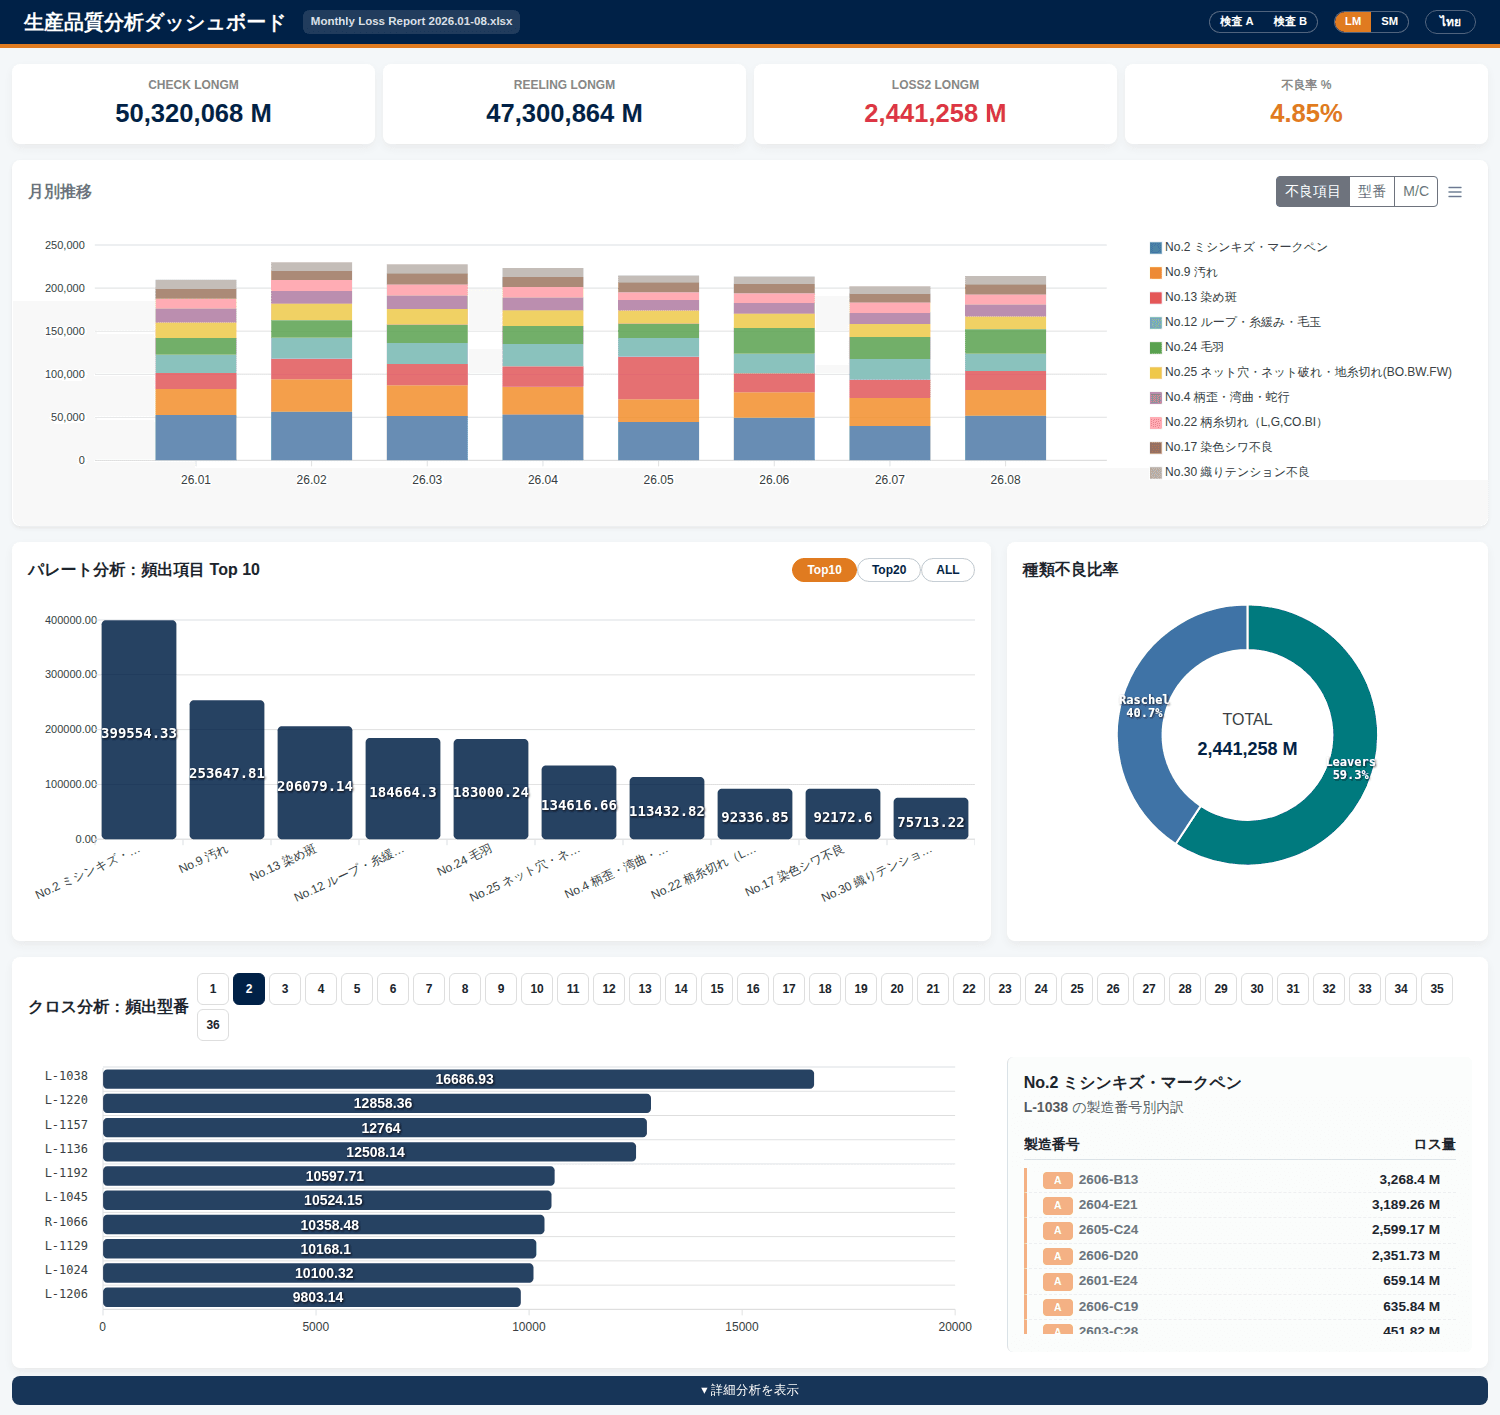
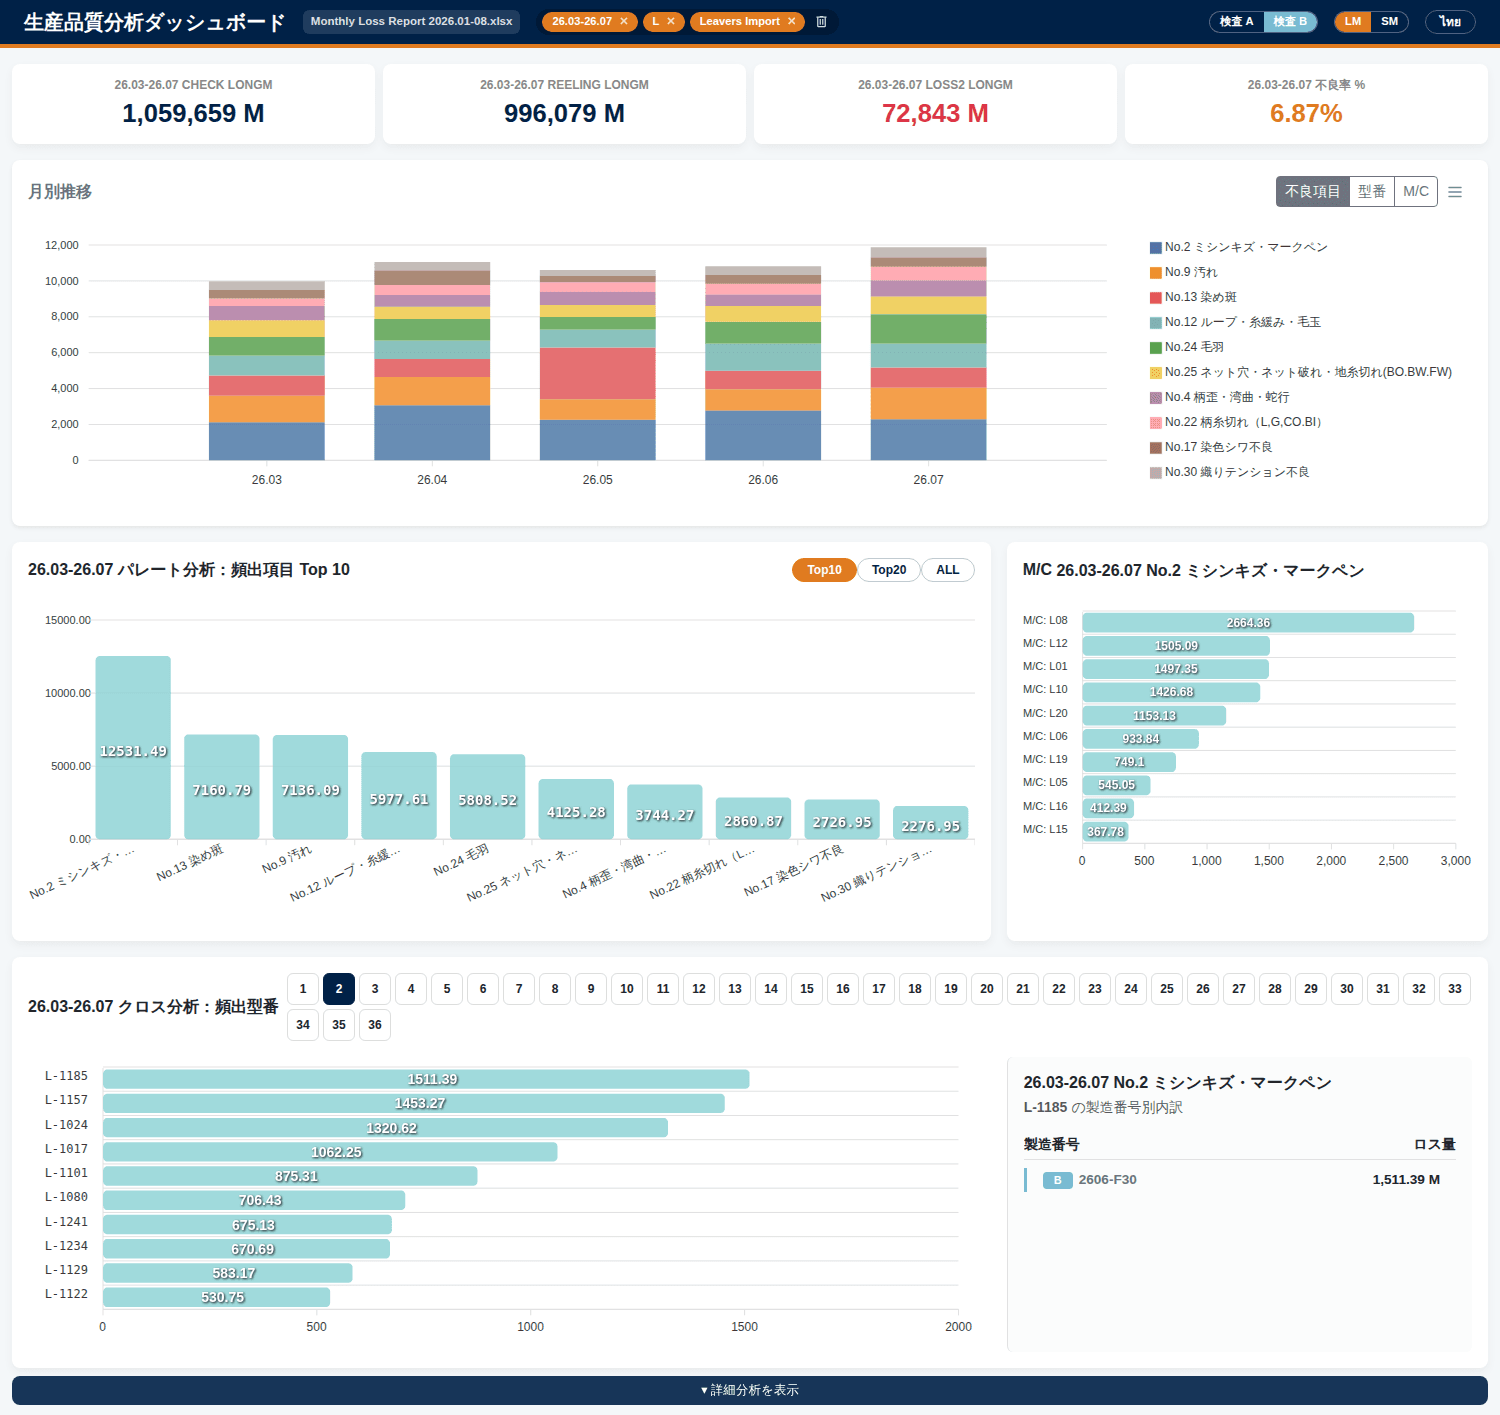
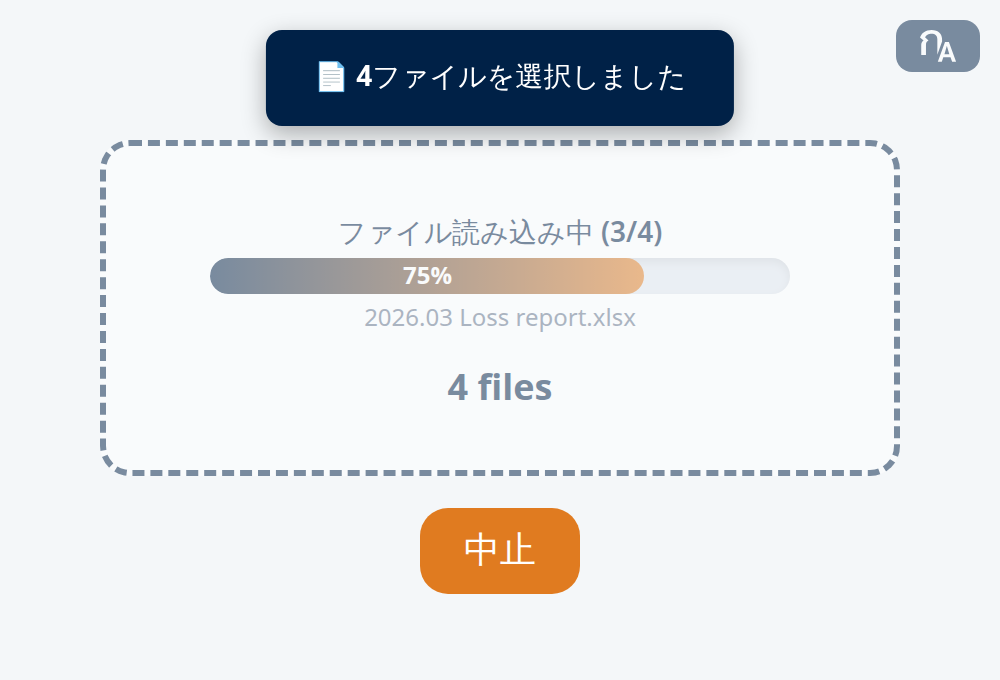
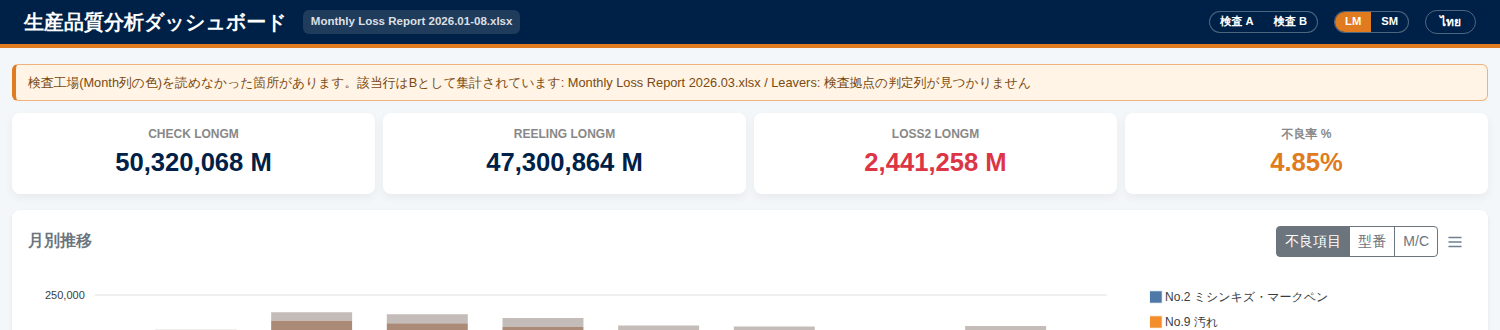
複数のExcelをドラッグ&ドロップすると、不良項目のパレート図、月別推移、機械・型番別のクロス分析を持つ単一のダッシュボードを生成します。グラフはすべて相互に連動し、ドーナツの中心クリックで一段階戻る、月別グラフのドラッグで期間をズームする、といった操作で絞り込みが積み重なります。絞り込み条件は画面上部のチップで常に見え、ワンクリックで個別に解除できます。 機種区分と自社/外注の2軸は、ドーナツを2段階に掘り下げる形にしました。一方、検査拠点は独立した軸としてナビの切替ボタンに置き、どの階層にいても1クリックで全グラフに反映されます。階層に組み込まなかったのは、KPIとして常時見せたい軸を3クリック先に隠さないためです。日本語・タイ語はボタン1つで切り替わり、ボタンには押した結果(切り替わる先の言語)を表示しています。
技術選定・アーキテクチャ
Tauri v2 + Rust を選んだ理由は3つです。(1) ExcelのシートXMLは大きいもので数MBあり、複数ファイルを一括処理する集計はネイティブ実装が向いていること。(2) 社内のPCで動かすため、サーバーを立てずローカルで完結させたいこと。(3) 配布物を小さくしたいこと(リリースビルドはサイズ優先・LTO有効で構成)。 出力は、データとロジックを埋め込んだ自己完結のHTML1ファイルです。閲覧する側はアプリを入れる必要がなく、メールやチャットで送るだけで同じ画面が開きます。ただし、グラフライブラリとフォントはCDNから読み込んでいるため、現状は閲覧時にネットワーク接続が必要です。完全オフライン化(インライン埋め込み)は次の改善候補として残しています。
技術的工夫①: Excelの書式から「検査拠点」を読み取る
現場のルールでは、Excelの月の列に背景色が付いている行は一方の拠点、付いていない行はもう一方の拠点で検査されたことを意味します。しかし、使っていたExcel読み取りクレート(calamine)はセルの値しか返さず、塗りつぶし色は取得できません。 代替として、書式を読めるフォーク版クレート、別の全機能クレート、Pythonのopenpyxlの移植、JavaScriptのSheetJSを比較しました。フォーク版は保守リスク、全機能クレートは「もう1つの完全なパーサー」を抱える行ずれのリスク、SheetJSは塗りつぶし色の読み取りが有償版限定、という理由で見送り、xlsxがZIPであることを利用して、スタイル定義と対象列のセルだけを直接読む方式を採りました。セルのスタイル番号から、セル書式、塗りつぶし定義と辿る二段構造をたどるだけなので、追加するのは軽量なZIP/正規表現クレートのみです。 実装前に、実データ19ファイル・約4万行で色の分布を確認し、Pythonで同じ手順を再現して結果が一致することを確かめました。この機能により、Web明細の各行に検査拠点のタグが付き、全グラフを検査拠点で絞り込めるようになりました。
技術的工夫②: 静かな失敗を作らない
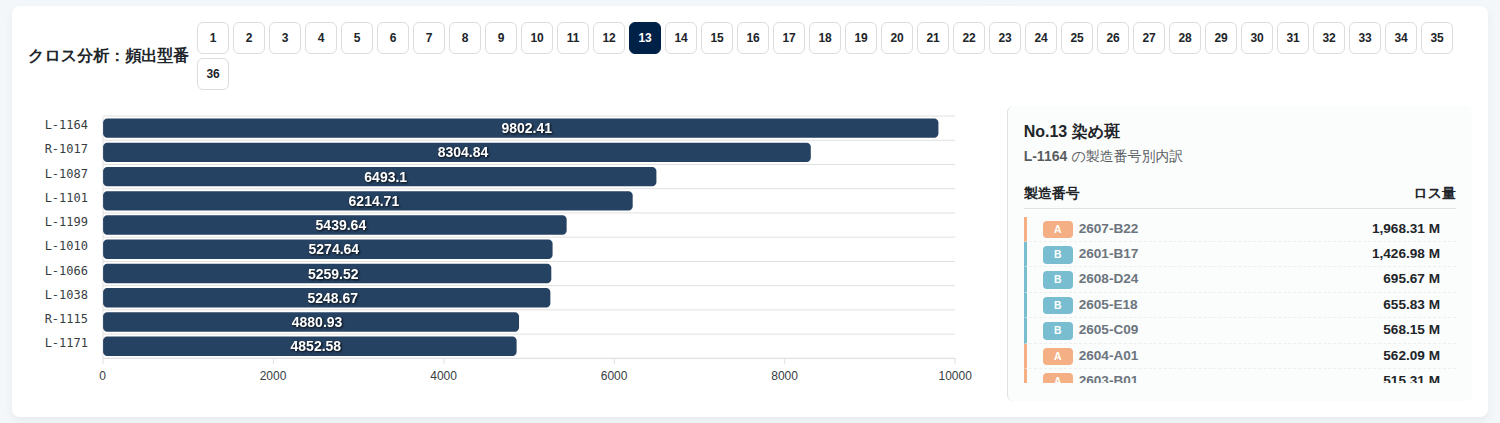
検査拠点の色が読めない場合、その行は全て「色なし」側に振り分けられます。当初は失敗を握りつぶして本体の集計を続けていましたが、検査拠点を部門キーに組み込んだ時点で、失敗が集計結果そのものを誤らせる状態になっていました。そこで、読めなかったファイル・シートを収集し、レポート上部に警告帯として表示するようにしました。 もう1つは自分の設定ミスです。ZIPクレートを既定のfeatureのまま追加したため、実機のcargo checkでロックファイルに22パッケージが増えていることが判明しました。圧縮形式の対応が全て有効になり、Cコンパイラが必要なクレートまで入っていたためです。xlsxに必要なのはdeflateのみなので、既定featureを外して再確認し、22パッケージの削除をロックファイルで確認しました。 また、シート名の揺れ(末尾空白・大小文字)を吸収するために判定を緩めた際、加工指図ベースの別形式シートまで読み込む副作用が出たため、名前で除外しました。
技術的工夫③: 容量と速度を意識したデータ設計
ダッシュボードの数値はすべてブラウザ側で再計算するため、月別データをそのまま埋め込みます。キー名の短縮、全期間合計と全部門合計は出力せずブラウザ側で月別データから導出する、部門バケットは初回アクセス時にだけ集計する遅延評価、といった工夫でHTMLを軽く保っています。 検査拠点の追加で部門キーが4通りから8通りに増えるため、実データ19ファイルで増加量を先に概算しました。容量の大半を占める製造番号の行データは「振り分けられるだけ」で増加0.0%、型番のキーが約+24%、機械のキーが約+64%でした。データが無い部門はノード自体を出力しないことで、この増加分も相殺しています。
経営層向けの詳細分析
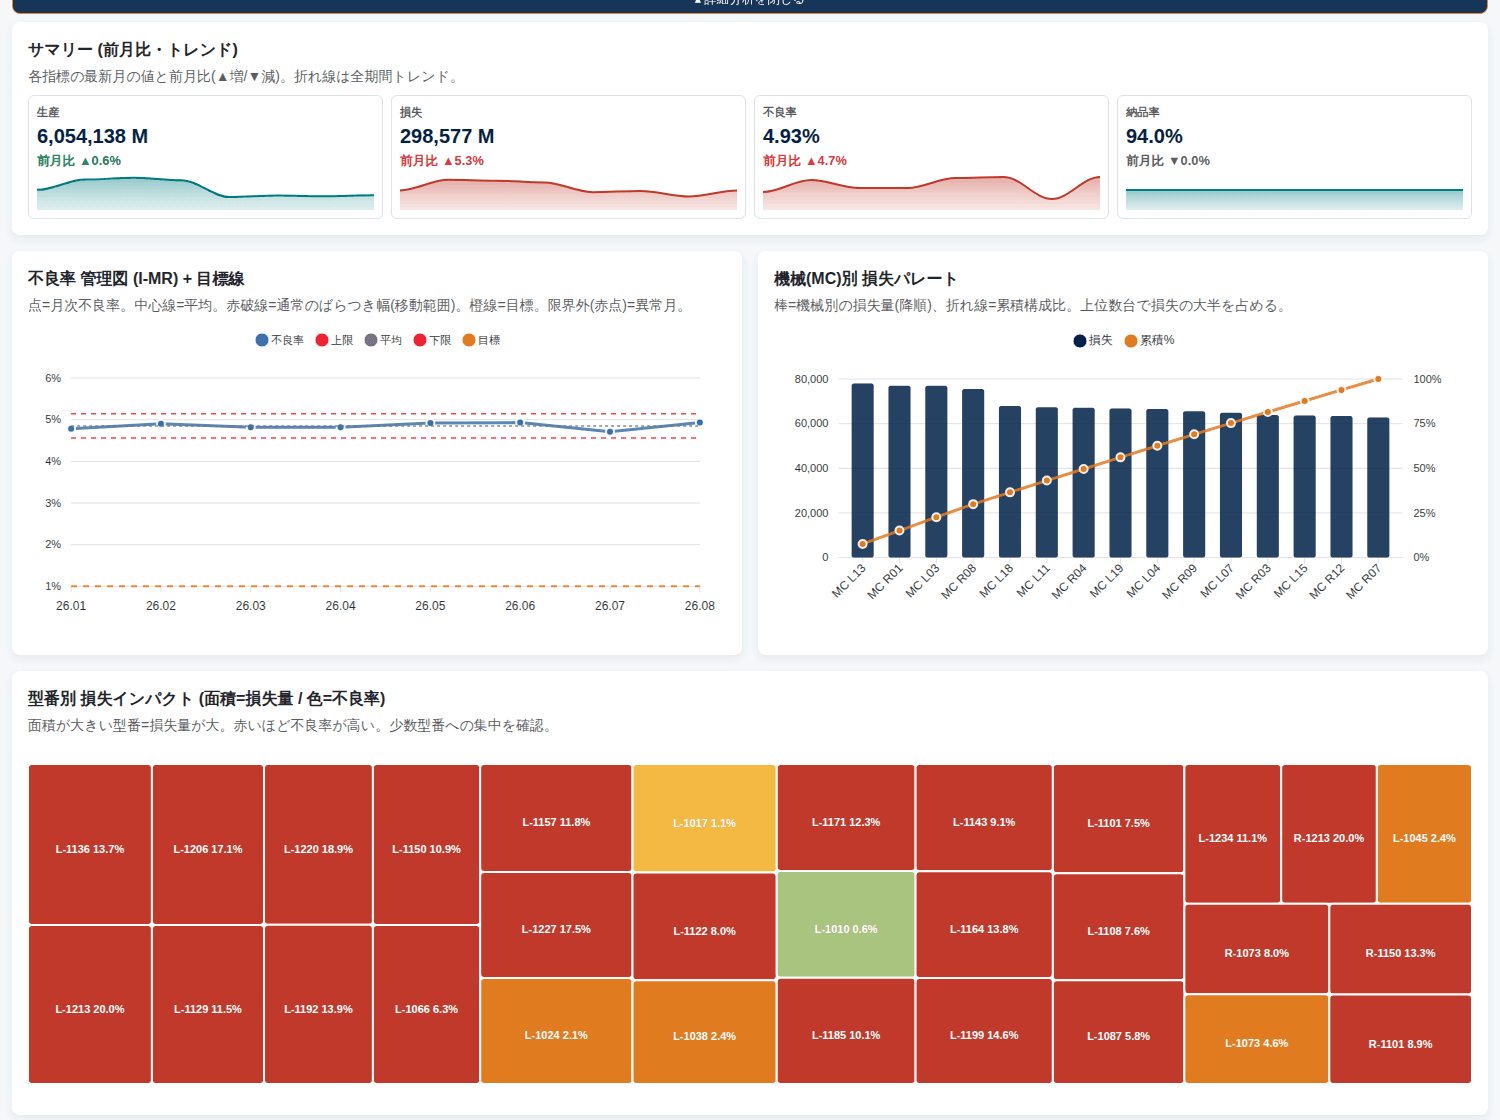
複数月のレポートでは、折りたたみ式の詳細分析を用意しています。前月比つきのKPIサマリー、不良率の管理図(個別値・移動範囲方式)、機械別損失のパレート図と累積比、型番別の損失インパクトを面積で示すツリーマップです。それぞれに非専門者向けの「見方」を添え、数値の意味を説明なしで読み取れるようにしています。
多言語対応
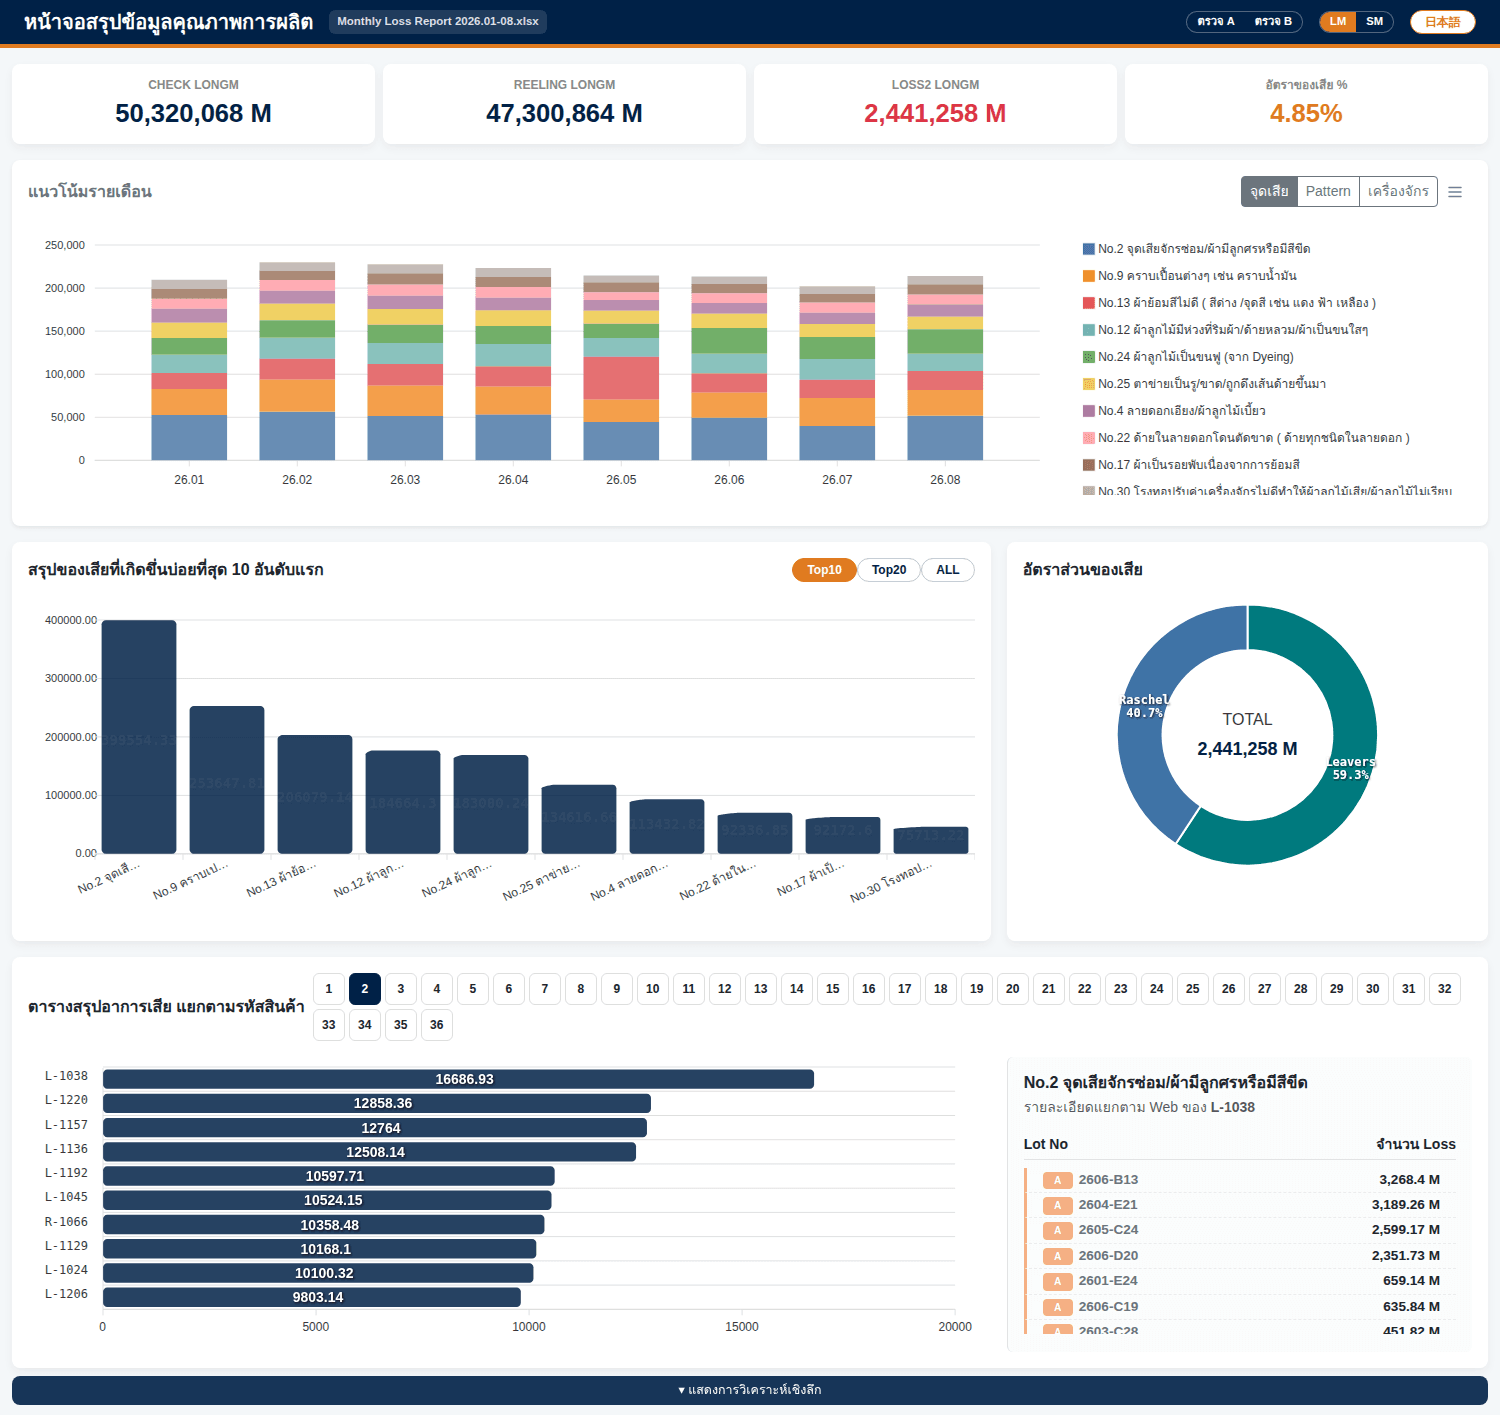
拠点の担当者の言語に合わせて、画面全体・グラフ凡例・不良項目名を日本語とタイ語で切り替えられます。日本語とタイ語では文の語順が違うため、見出しの「Top N」のような動的な文言は、数字を差し込むテンプレートにして両言語で自然な文になるようにしています。
姉妹アプリ: 染色不良を生産データベースと結合して分析
損失Excelには、不良は記録されていても、どの染色機で処理されたかは含まれていません。そこで、別アプリとして、損失Excelと生産データベースの染色計画をODBCで直接結合する分析ツールを作りました。結合キーは型番とロット番号(6桁ゼロ埋め)で、ロット番号は年で一巡するため、Excelの年月に最も近い染色日を採用しています。 実データでの機械特定率は約97%です。特定できなかった行も「不明」として集計に含めているため、不良の合計は元のデータと一致します(参照データとの差0.0%)。未特定の主因は、同じ型番でもExcel側とDB側のロット番号が食い違うことで、型番+日付近接でのフォールバック結合を次の改善として検討しています。
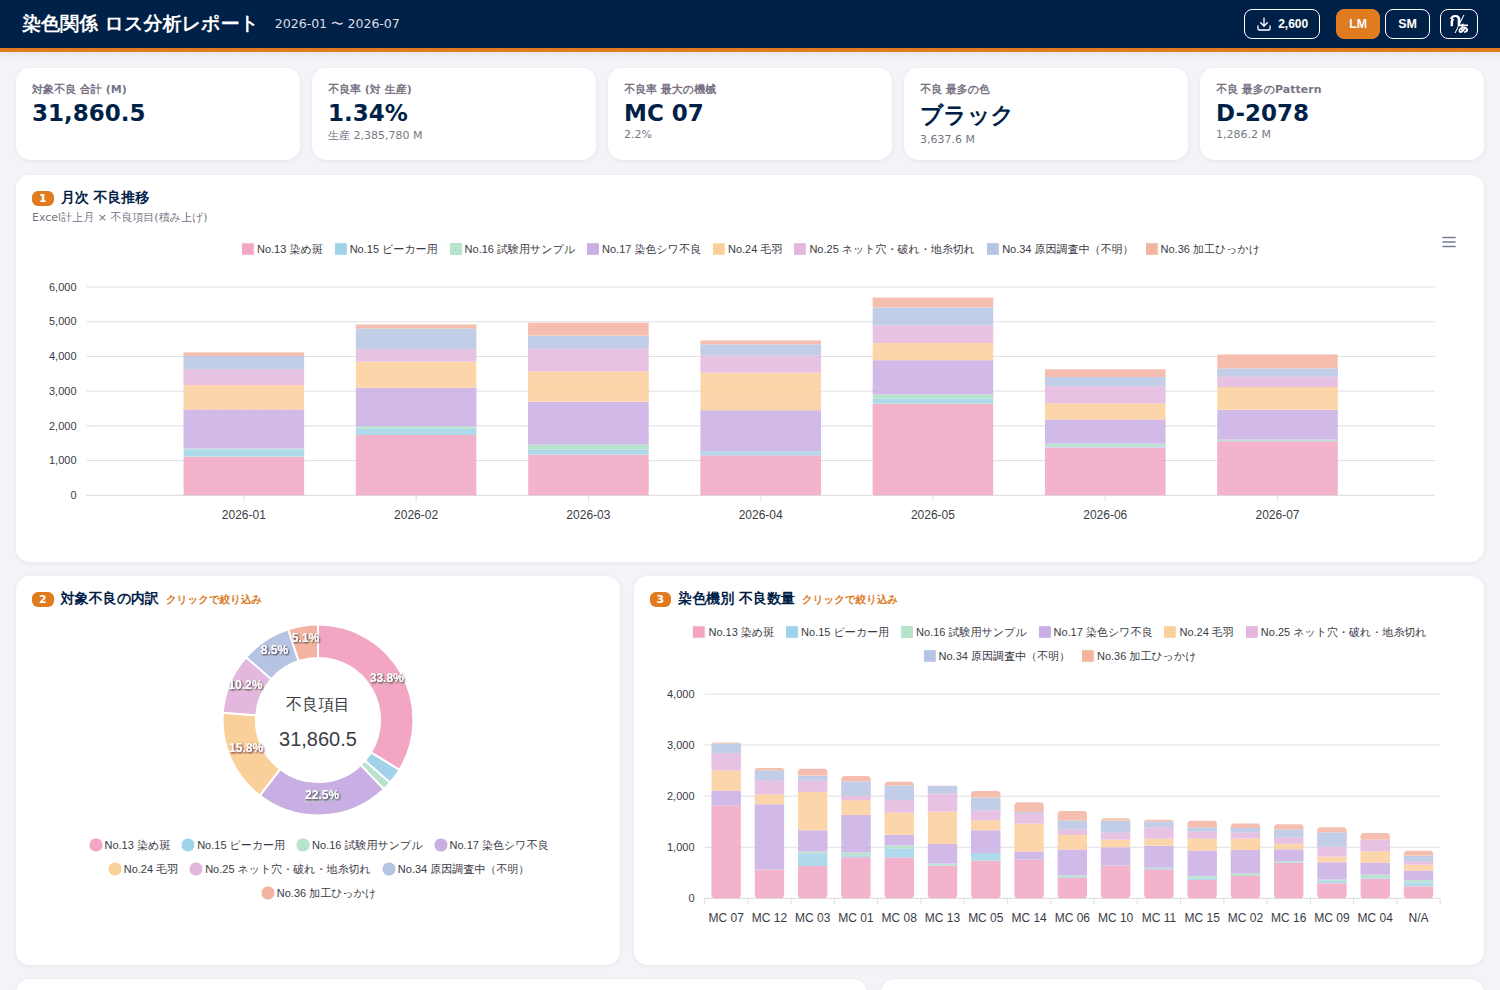
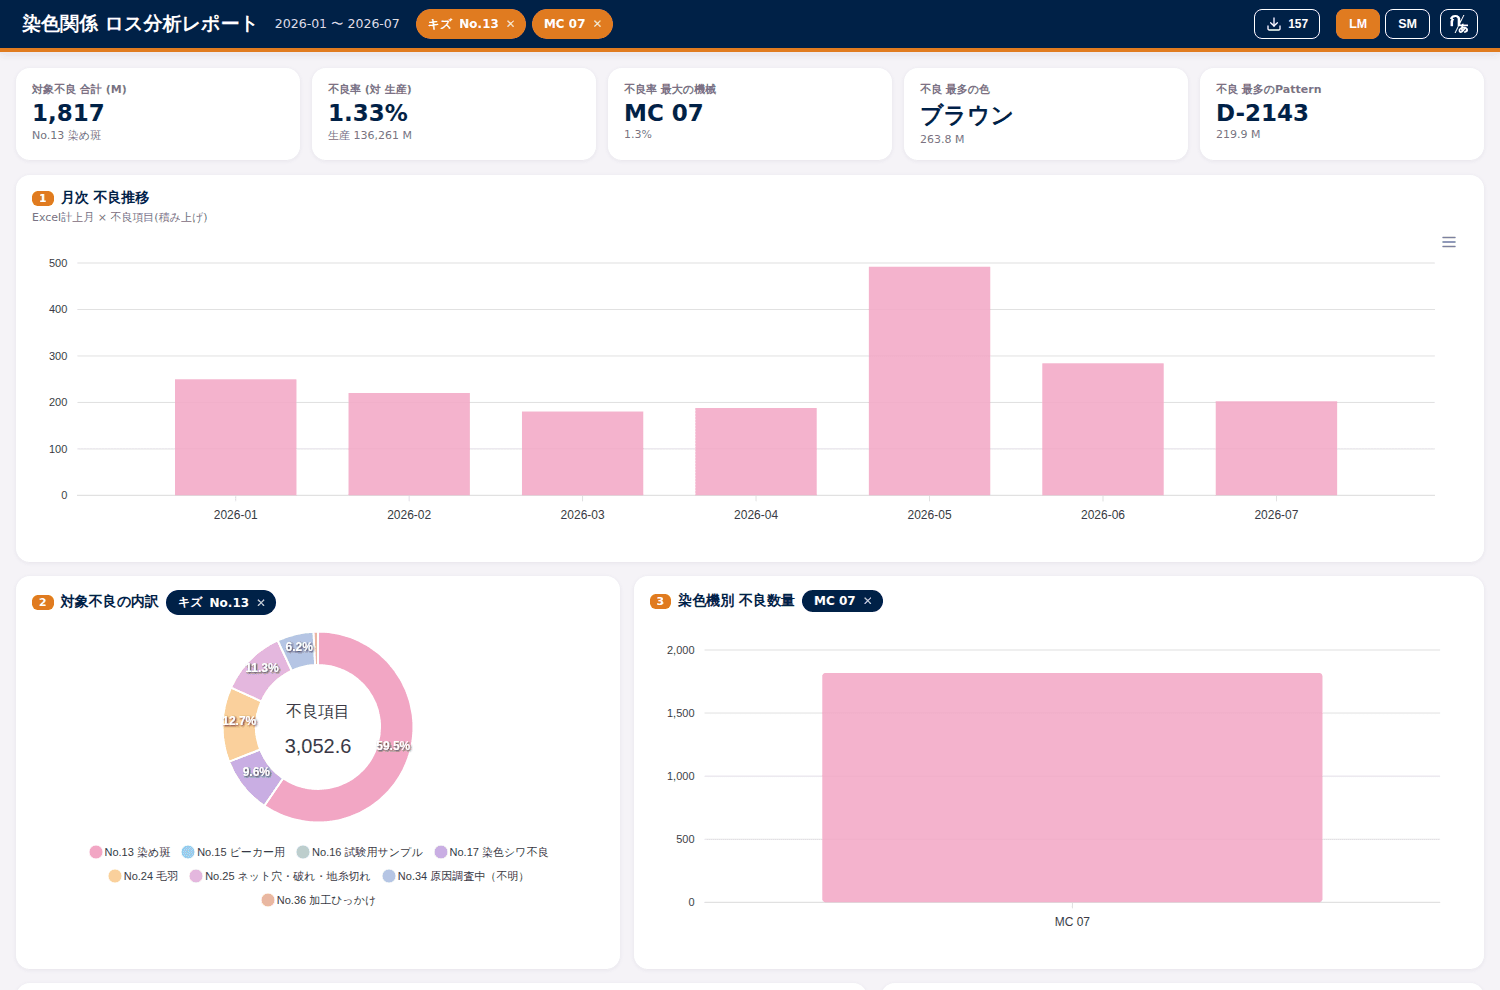
染色不良: クロスフィルタで原因に迫る
不良項目、染色機、型番、色、再染の有無、曜日、浴数、染色回数などを条件に、すべてのグラフと表が連動して再計算されます。画像は「染め斑」に絞ったうえで特定の機械に絞った状態です。月別推移から、特定月に不良が跳ね上がっていたことも読み取れます。絞り込み結果は明細として一覧化し、CSVで出力できます。
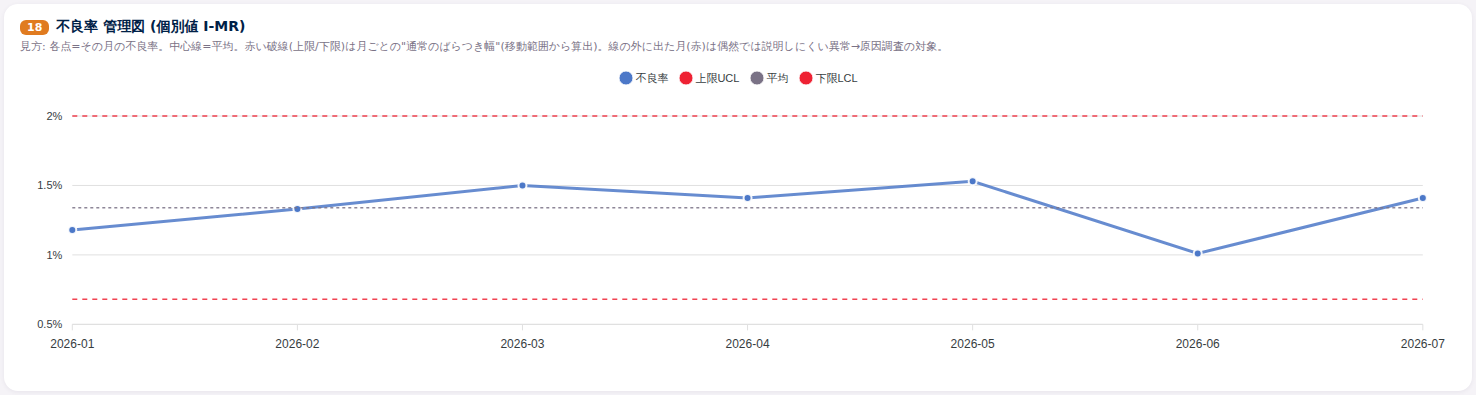
統計手法で「気のせい」を排除する
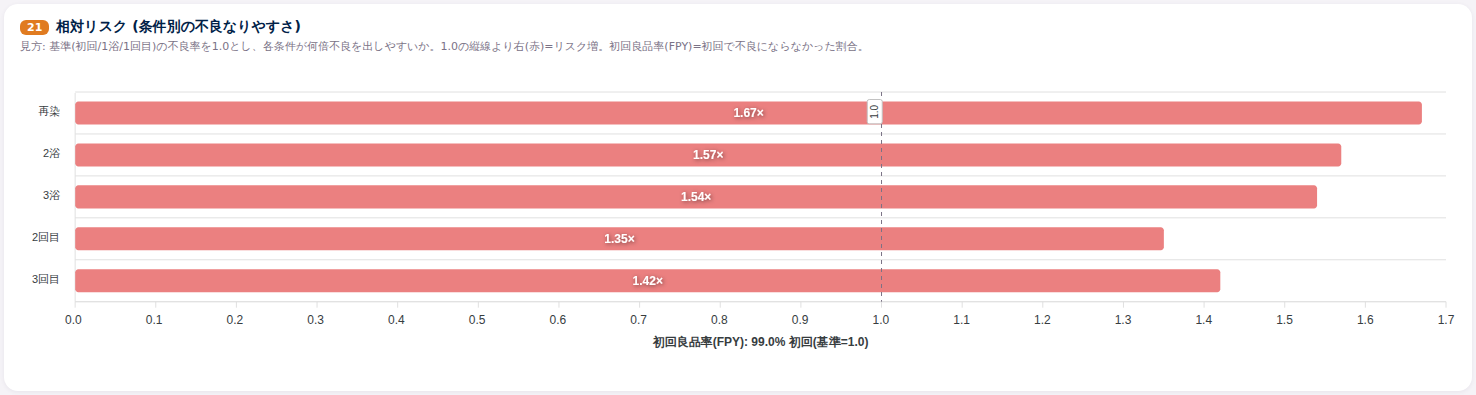
月次の不良率は、平均±2.66×平均移動範囲の管理図(I-MR)で異常な月を判定します。当初は不良率の管理図(p管理図)を検討しましたが、生産量が大きく過分散になるため個別値方式に変更しました。機械×不良の偏りは、生産量の差を補正した標準化残差のヒートマップで、初回/再染や浴数などの条件は、基準を1.0とした相対リスクで示します。 同時に複数の不良が出た行の共起マトリクスも用意し、共通原因の可能性を探れるようにしています。各カードには「見方」を添えています。
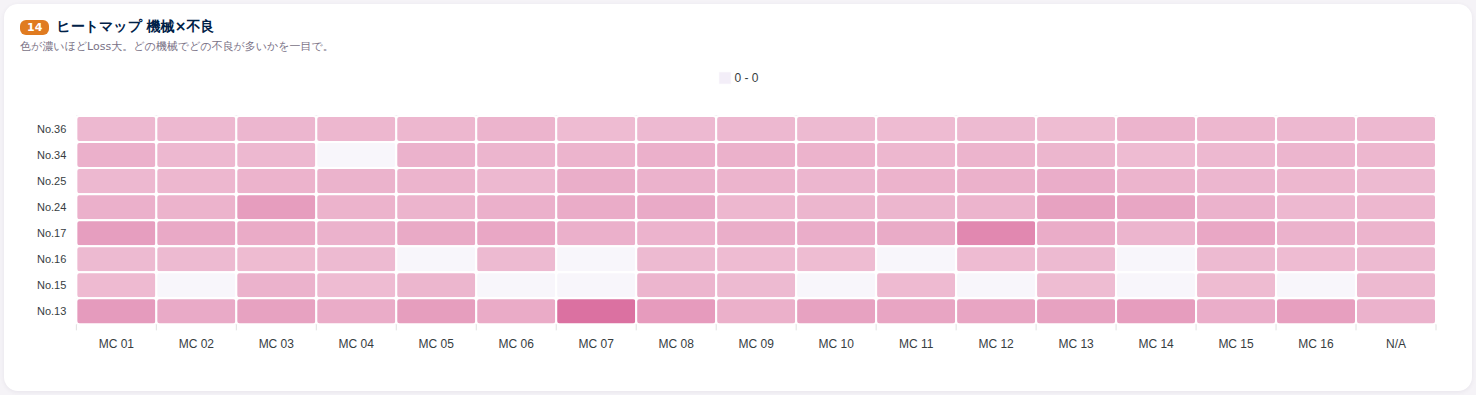
機械×不良の偏りを一目で
機械ごと・不良項目ごとの損失量をヒートマップで示します。濃い色のセルが集中している機械は、その不良に対して優先的に調査すべき対象になります。パレート図(機械別の損失と累積比)と併用することで、少数の機械への集中度も確認できます。
再染は本当に不良を出しやすいのか
初回・1浴・1回目を基準(1.0)とし、条件ごとに不良の出やすさを倍率で示します。あわせて、初回で不良にならなかった割合(初回良品率)も表示します。「再染すると不良が増える気がする」という感覚を、条件別の数字として確かめられます。
成果・現状と今後
現場のExcelをそのまま入力に、表計算での再集計を経ずに全体像から原因まで辿れる分析画面を生成できるようになりました。バイリンガル対応、検査拠点別の絞り込み、生産DBとの結合による機械特定と統計分析まで含め、2つのアプリとして実装し、実機で確認しながら改善を続けています。 工数削減量や改善効果などの定量的な成果は、導入前後の計測をしていないため現時点では「要確認」です。今後の課題として、完全オフライン化(グラフライブラリのインライン化)、DB結合のフォールバック、損失の金額換算(単価データ未提供)が残っており、いずれも継続中です。また、開発の一部はWindows実機を持たない環境で行ったため、Rust側の変更は実機でビルド・動作確認しながら段階的に反映しています。