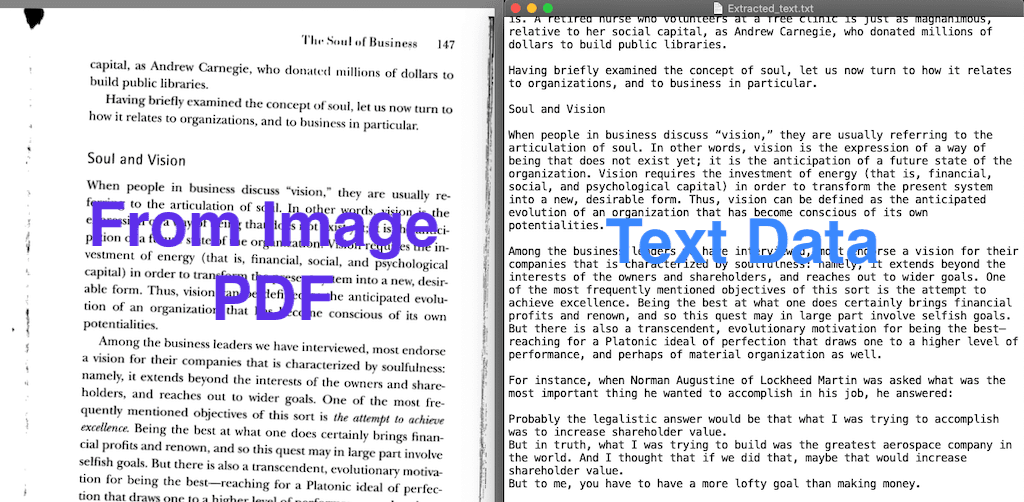
画像のみのPDF ファイルからテキスト データを抽出
情報
スキル: Computer Vision, CV2, Tesseract, OCR, Regex
Link: Private
作成日: 2023-10-10
プロジェクト概要
テキストデータが埋め込まれていない画像のみのPDFファイルはテキストを選択できないため、コピー&ペーストや機械翻訳ができません。 また、スマートフォンやブラウザでの音声読み上げも機能しません。 これらの問題を解決するには、テキストを自動的に抽出するプログラムを作成します。 まず、PDF からすべての画像を抽出します。 傾いた画像の歪みを自動的に補正し、OCR の精度を向上させます。 ヘッダー、フッター、余白などの余分な領域を自動的に検出して削除します。 OCR を使用して、クリーンアップされた画像からテキストを抽出します。 抽出されたテキストは、ハイフンや不要なスペースを削除して単語に変換されます。 数百ページのPDFファイルを一度にテキストデータに変換できます。 *英語のプロジェクトです